Inverse Kinematik
Statt jede Gelenkstellung auszurechnen, lernt der Arm per Reinforcement Learning, wie er sein Ziel erreicht. Ein zusätzlicher Bellman-Term lässt das Training schneller zum Ziel kommen.
schnellere Konvergenz
Trainingsläufe
So ist das Projekt gelaufen.
- 01
Arm modellieren
Kinematik mit mehreren Freiheitsgraden als Simulation.
- 02
Lernumgebung
Gym-kompatible Umgebung: Der Agent bekommt Zustand, Ziel und Belohnung.
- 03
Bellman-Term
Das Bellman-Prinzip fließt direkt ins Training ein. Ergebnis: rund 30 % schnellere Konvergenz.
- 04
Training
Verteilt auf eigener GPU-Hardware, über 500 Läufe.
- Reinforcement Learning
- Gym
- PyTorch
- Kubernetes
- GPU
Akademischer Proof of Concept, kein Kundenprojekt.
Ihre Anlage ist die nächste?
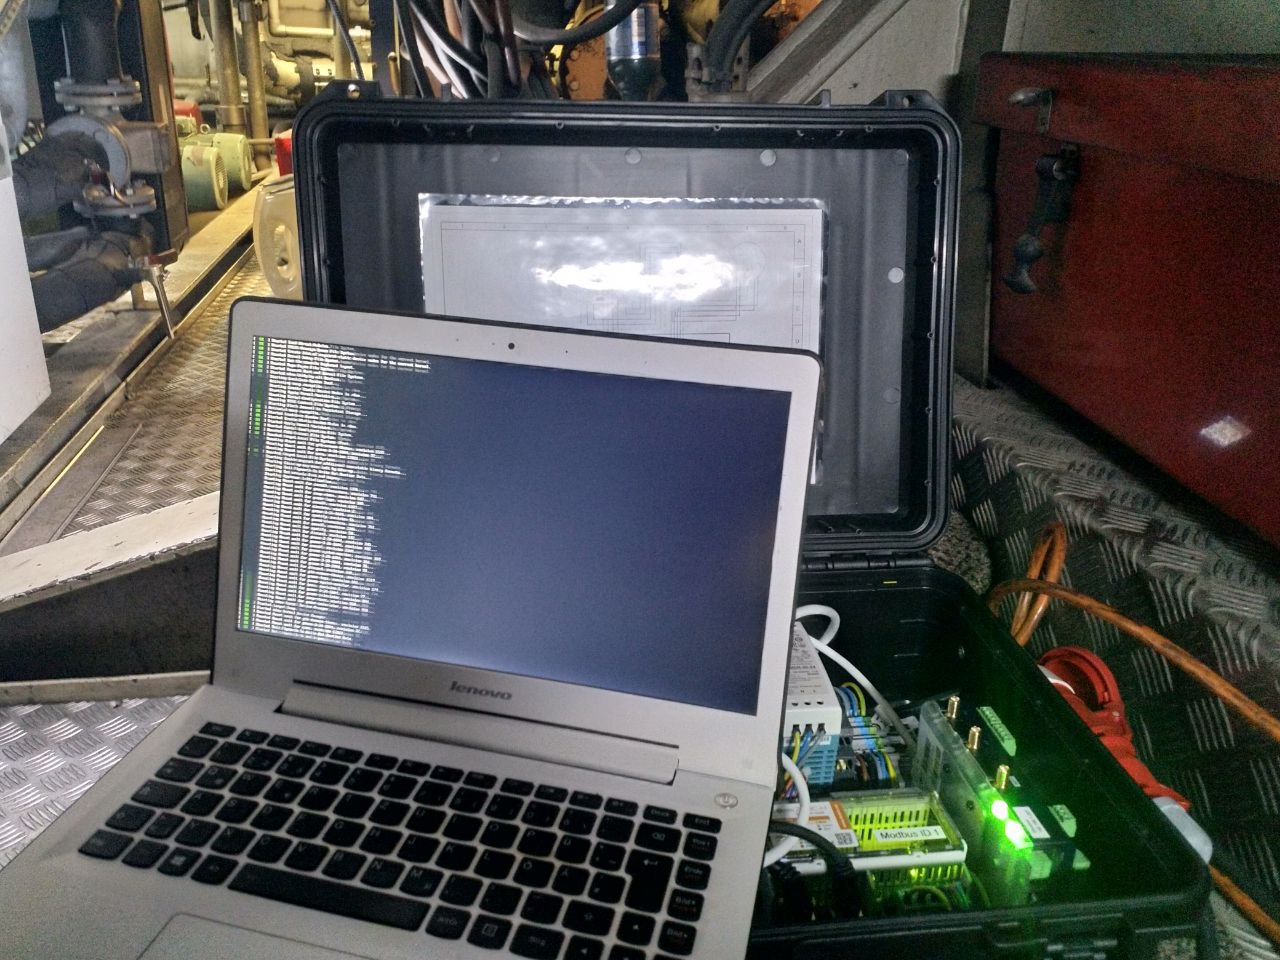
Schiffsmotoren
EFREVerschleißerkennung mit Fraunhofer IGP und IBM. Vor der Gründung von Overfit betreut.
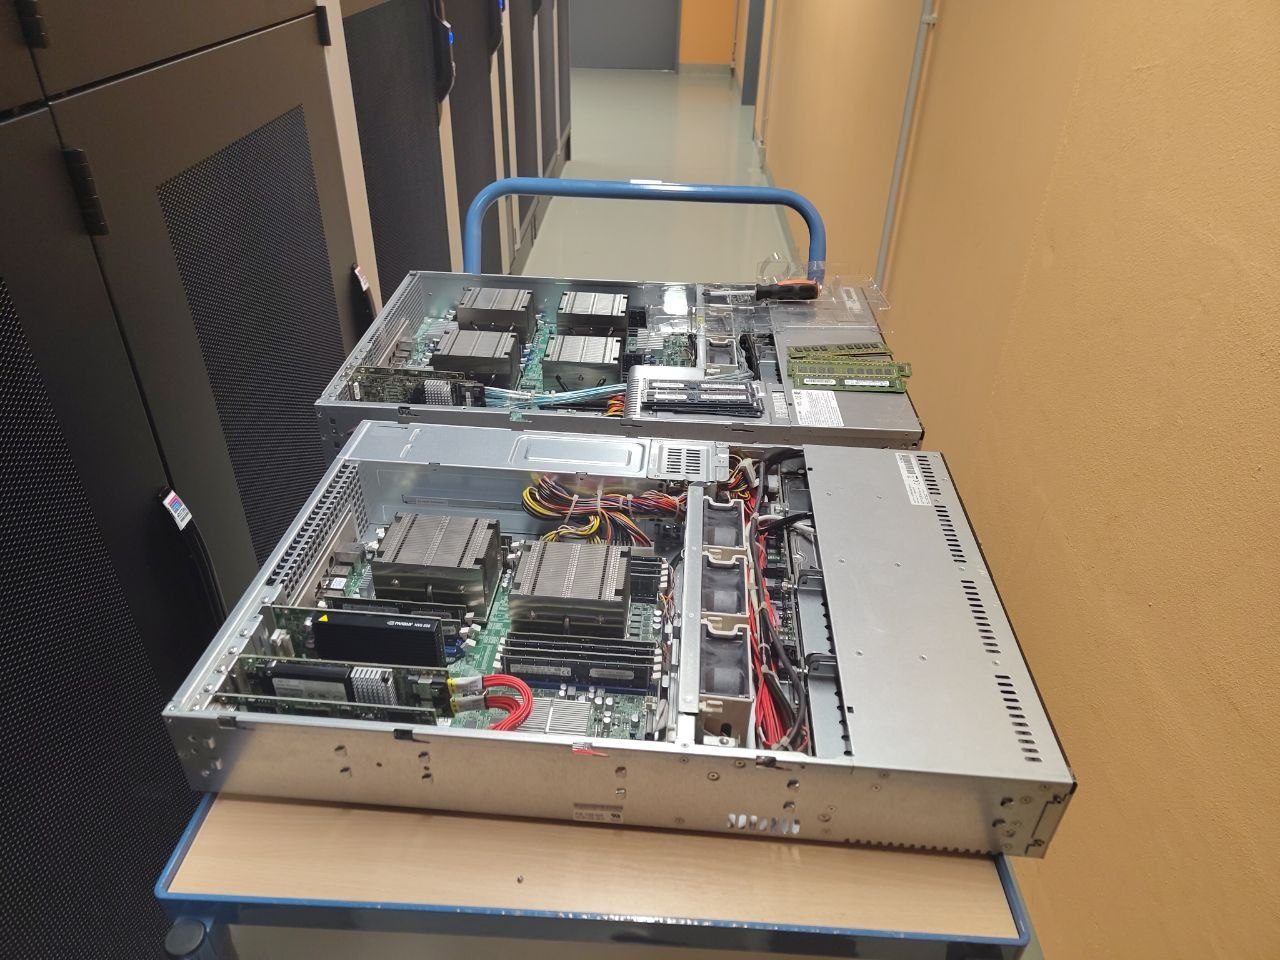
Kubernetes auf Bare Metal
HAKubernetes auf eigener Hardware: hochverfügbar, vier redundante Leitungen, Notstrom.
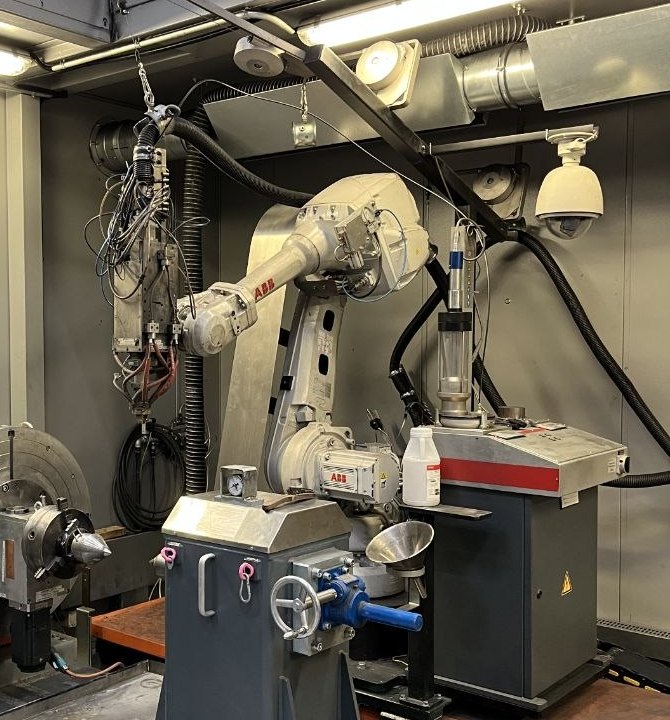
Laserauftragsschweißen
10 Hz98 Prozesssignale aus der Siemens-Steuerung, zehnmal pro Sekunde.